Hvorfor skulle et selskap på tre personer bygge sin egen AI?
På grunn av et løfte vi gir hver eneste kunde: Dataene deres blir i miljøet deres, og ingenting sendes til en ekstern AI-tjeneste.
Det løftet utelukker den enkle veien. Den opplagte måten å finne personopplysninger i et saksnotat på er å sende notatet til en stor AI-leverandør og lese svaret. Det fungerer godt. Det betyr også at hendelsesrapportene, vaktnotatene og registreringene om de ansatte forlater miljøet deres og havner et sted dere ikke har kontroll over.
Derfor må AI-en i plattformen vår kjøre på maskinvare som dere eller vi kontrollerer. Det betyr små modeller, bygget for én jobb hver, og gode nok på den jobben til å være nyttige.
Tre av dem er nå offentlig tilgjengelige på Hugging Face, gratis å laste ned og bruke under Apache 2.0-lisensen.
Hva de tre modellene gjør
| Modell | Hva den gjør |
|---|---|
| Nordic PII Spans | Leser norsk og svensk tekst og lister opp alle personopplysningene i den — navn, telefonnumre, adresser, fødselsnumre, helseopplysninger og annet — og knytter hver av dem til personen den gjelder, slik at teksten kan skjules konsekvent |
| Nordic PII Screen | Svarer på et spørsmål som går raskere: Hvilke typer personopplysninger inneholder denne teksten? Tekster uten noen kan hoppes over, og det den første modellen overså, blir fanget opp |
| Nordic Customer Impact | Leser én melding fra en kunde til en bedrift og svarer på atten spørsmål om den på én gang: hva kunden vil, hva kunden føler, om noe er i stykker, hvor mye det haster og hvilke risikoer meldingen innebærer. Seks språk |
Hver av dem er liten nok til å kjøre på én enkelt maskin og altfor liten til å gjøre alt. Det er poenget. En modell som gjør én jobb, kan måles på den jobben.
Hver eneste person i treningsteksten er oppdiktet. Ingen ekte dokumenter er brukt, og ingen ekte personers opplysninger.
Hvorfor nordisk tekst er et problem for seg
Det er her en generell modell, som for det meste er trent på engelsk, får problemer.
I Norge får gater navn etter personer. Henrik Ibsens gate er en adresse, ikke en dramatiker. Møterom får også navn etter personer: møterom Ivar Aasen er et rom. En modell som flagger begge, er ubrukelig i praksis, for noen må gå gjennom hver eneste falske alarm — og et verktøy som roper ulv, blir slått av.
| Ser ut som personopplysninger | Er egentlig |
|---|---|
| Henrik Ibsens gate | En gate |
| Møterom Ivar Aasen | Et møterom |
| post@ eller support@ | En fellespostkasse, ikke en person |
| Ordre-, saks- og fakturanumre | Henvisninger til ting, ikke til personer |
| Stillingstitler, organisasjoner, steder | Kontekst, ikke identitet |
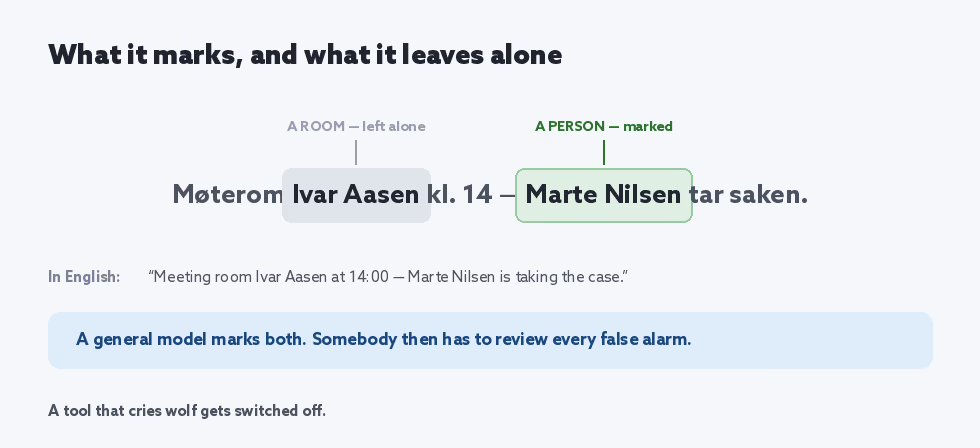
Ingenting av dette står i et generelt datasett. Alt sammen er opplagt for den som har jobbet på et nordisk kontor i en uke.
Det finnes et gap til, og det viser seg bare i ekte arbeidstekst. Notater fra felt er ofte to linjer lange: en dato og et ord eller to om hva som ble gjort. 14.03 · Vask. En tidlig versjon av modellen vår leste det enslige ordet med stor forbokstav under en dato som navnet på en person, for i alle de ordentlige setningene den hadde sett, var et ord med stor forbokstav på den plassen et navn.
To personer var enige i 64 % av tilfellene
Customer Impact-modellen svarer på atten spørsmål om en melding. For å kontrollere den måtte mennesker først svare på de samme spørsmålene for hånd.
Da to opplærte personer leste de samme kundemeldingene, var de enige om hovedkategorien i 64 % av tilfellene. Uenigheten samlet seg der man skulle vente: Er dette et problem, en klage eller en fakturasak? Ofte er det alle tre.
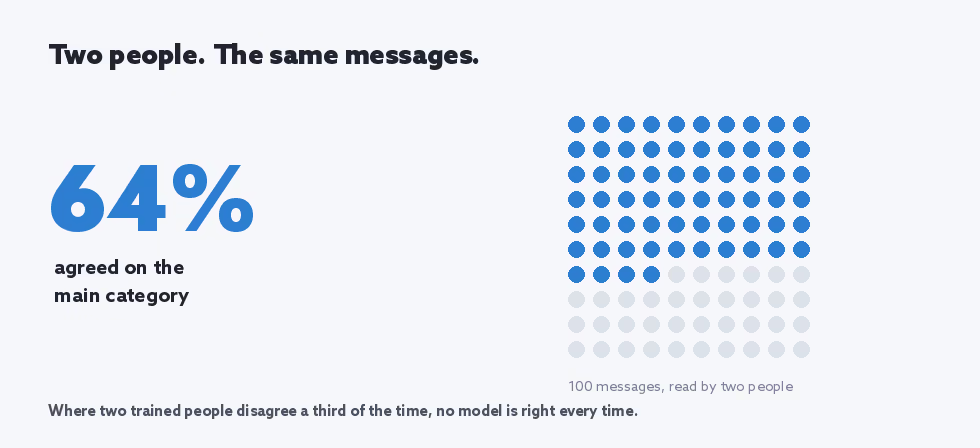
Det tallet blir sjelden publisert, fordi det får nøyaktighetstall til å se mindre imponerende ut. Vi vil heller at dere skal ha det, for det forteller dere noe ingen nøyaktighetstall kan.
Svaret er å la modellen si hvor sikker den er.
Hvorfor en sannsynlighet slår en merkelapp
De fleste verktøy av denne typen gir dere en merkelapp. Denne meldingen er en klage. Dere aner ikke om verktøyet var sikkert eller bare gjettet, så dere sjekker alt, og automatiseringen sparer ingen for tid.
Customer Impact-modellen vår oppgir for hvert svar hvor sikker den er, og de tallene er ærlige: Når den sier 80 %, har den rett i omtrent 80 % av tilfellene. Det blir til en regel hvem som helst kan følge:
- Sikkert svar → send det videre automatisk.
- Usikkert svar → send det til et menneske.
- Alvorlig eller sensitivt — en sikkerhetsrisiko, eller noen i en vanskelig situasjon — → et menneske, med en gang, uansett hvor sikker modellen er.
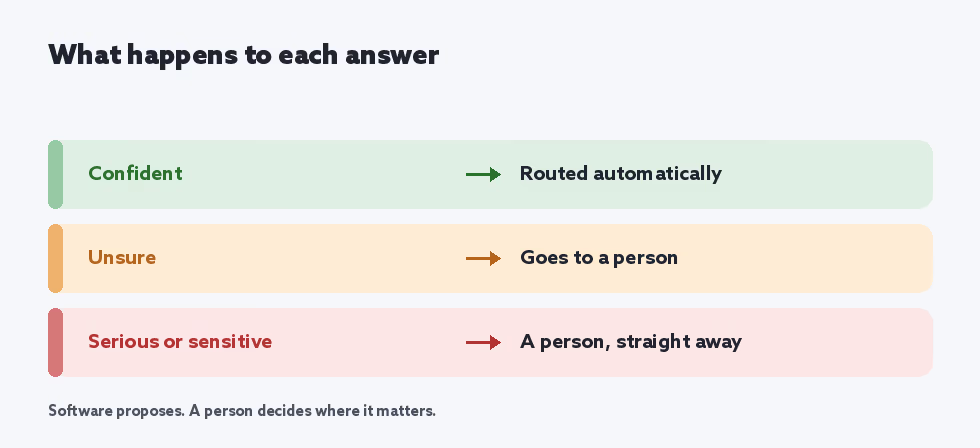
Den siste regelen er bygget inn i referansekoden vi har publisert, i stedet for å være noe noen må huske. Den samme tankegangen går igjen i hele plattformen: Programvaren foreslår, og et menneske bestemmer der det betyr noe.
Der disse modellene er svakest
Fire begrensninger, alle publisert på modellkortene.
De har lært av oppdiktet tekst. Ekte dokumenter er mer rotete — forkortelser, skrivefeil, halve setninger, lokale kortformer. Test dem på et utvalg av deres egen tekst før dere stoler på noe av dette, og ha et menneske med der en glipp betyr noe.
Nynorsk er den svakeste målformen. Eksakt treff ligger på 0,96 for bokmål mot 0,88 for nynorsk. Mindre materiale å lære av, lavere resultat.
Fritekstkategorier har uklare kanter. Å finne ut at en setning nevner sykdom, er pålitelig. Å bli enige om nøyaktig hvor omtalen begynner og slutter, er vanskeligere — for en modell, og for to mennesker.
På risikospørsmål velger de forsiktighet framfor dekning. Signaler som kundefrafall og sikkerhet blir funnet i 77 til 84 % av meldingene som inneholder dem. Der en glipp koster mer enn en falsk alarm, bør terskelen senkes — og den beslutningen er det virksomheten deres som må ta, ikke vi.
Hvorfor gi dem bort?
Et rimelig spørsmål til et selskap med tre personer og et stramt budsjett.
Dels fordi det koster oss lite å publisere modellene, og det gir nordiske organisasjoner noe som stort sett ikke finnes: åpne modeller som håndterer norske og svenske personopplysninger skikkelig, kjører på deres egen maskinvare og kan kontrolleres av hvem som helst. Treningsmaterialet beholder vi selv.
Dels fordi det er den eneste ærlige måten å komme med påstanden på. En leverandør som sier vår private AI beskytter dataene deres, ber dere ta dem på ordet. Her er modellene, tallene, kategoriene og begrensningene. Last dem ned og test dem selv.
Dette bør dere spørre enhver leverandør som lar AI lese registreringene deres
- Hvor havner teksten? Er en ekstern AI-tjeneste en del av svaret, forlater registreringene om de ansatte miljøet deres. Spør hvilken, og hva de tar vare på.
- Hva er modellen trent på? Ekte kundedokumenter eller oppdiktet tekst? Er de ekte: Hvem tilhører de, og med hvilken tillatelse er de brukt?
- Virker den på språket vårt? Norsk har to målformer. Svensk, dansk og finsk er andre problemer igjen. En modell som gjør det godt på engelsk, forteller dere svært lite.
- Hvor ofte tar den feil, og i hvilken retning? Å overse noe og å flagge noe harmløst er to forskjellige feil med forskjellige kostnader.
- Sier den fra når den er usikker? En merkelapp uten noe tall for hvor sikker modellen er, kan ikke automatiseres trygt.
- Kan vi teste den på vår egen tekst? Hvis svaret går ut på å laste opp de ekte dokumentene deres til et demomiljø, er det første spørsmålet allerede besvart.
Svarene våre står ovenfor, og modellene er offentlige, så dere kan kontrollere dem i stedet for å ta oss på ordet.
Bjørn Nese — Etablerer og teknologisjef
Har bygget driftsprogramvare for bransjer med strenge compliance-krav siden 2011. Designer plattformarkitekturen og den private, interne AI-en som driver den.
Flere artikler av Bjørn Nese