Varför skulle ett företag med tre personer bygga en egen AI?
På grund av ett löfte vi ger varje kund: era data stannar i er miljö, och ingenting skickas till en extern AI-tjänst.
Det löftet utesluter den enkla vägen. Det självklara sättet att hitta personuppgifter i en ärendeanteckning är att skicka anteckningen till en stor AI-leverantör och läsa svaret. Det fungerar bra. Det betyder också att era incidentrapporter, era skiftanteckningar och ert personalregister lämnar er miljö och hamnar någonstans där ni inte har någon kontroll.
Därför måste AI:n i vår plattform köras på hårdvara som ni eller vi har kontroll över. Det betyder små modeller, byggda för ett jobb var, och tillräckligt bra på det jobbet för att vara till nytta.
Tre av dem ligger nu öppet på Hugging Face och kan laddas ner och användas fritt under licensen Apache 2.0.
Vad de tre modellerna gör
| Modell | Vad den gör |
|---|---|
| Nordic PII Spans | Läser norsk och svensk text och listar alla personuppgifter i den — namn, telefonnummer, adresser, ID-nummer, hälsouppgifter med flera — och knyter var och en till den person den hör till, så att texten kan döljas på ett konsekvent sätt |
| Nordic PII Screen | Svarar på en snabbare fråga: vilka slags personuppgifter innehåller den här texten? Texter utan några kan hoppas över, och det som den första modellen missade fångas upp |
| Nordic Customer Impact | Läser ett meddelande som en kund har skickat till ett företag och svarar på arton frågor om det på en gång: vad kunden vill, hur kunden känner sig, om något har gått sönder, hur brådskande det är och vilka risker det för med sig. Sex språk |
Var och en är liten nog att köras på en enda maskin, och alldeles för liten för att göra allt. Det är poängen. En modell som gör ett enda jobb går att mäta på just det jobbet.
Varje person i träningstexten är påhittad. Inget verkligt dokument har använts, och inga uppgifter om någon verklig person.
Varför nordisk text är ett problem för sig
Det är här en generell modell, som mest är tränad på engelska, får det svårt.
I Norge är gator uppkallade efter personer. Henrik Ibsens gate är en adress, inte en dramatiker. Mötesrum är också uppkallade efter personer: møterom Ivar Aasen är ett rum. En modell som flaggar båda är oanvändbar i praktiken, eftersom någon måste granska varje falsklarm — och ett verktyg som ropar varg blir avstängt.
| Ser ut som personuppgifter | Är egentligen |
|---|---|
| Henrik Ibsens gate | En gata |
| Møterom Ivar Aasen | Ett mötesrum |
| post@ eller support@ | En funktionsbrevlåda, inte en person |
| Order-, ärende- och fakturanummer | Hänvisningar till saker, inte till personer |
| Befattningar, organisationer, platser | Sammanhang, inte identitet |
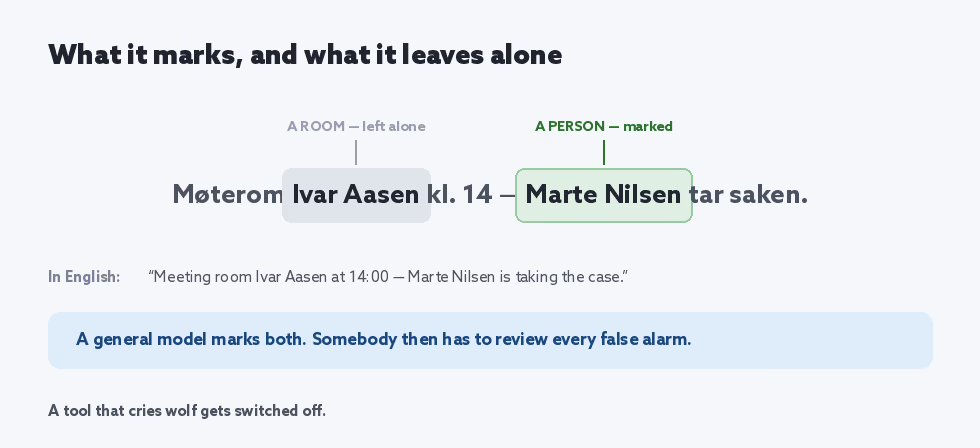
Inget av det här finns i en generell datamängd. Allt är självklart för den som har arbetat på ett nordiskt kontor i en vecka.
Det finns ett andra glapp som bara syns i verklig text från arbetet. Anteckningar från frontlinjen är ofta två rader långa: ett datum, och ett eller två ord om vad som gjordes. 14.03 · Vask. En tidig version av vår modell läste det ensamma ordet med stor bokstav under ett datum som någons namn, eftersom ett ord med stor bokstav på den platsen var ett namn i varje prydlig mening den hade sett.
Två personer var överens i 64 % av fallen
Nordic Customer Impact svarar på arton frågor om ett meddelande. För att kunna kontrollera modellen måste människor först svara på samma frågor för hand.
När två upplärda personer läste samma kundmeddelanden var de överens om huvudkategorin i 64 % av fallen. Oenigheten samlades där man kunde vänta sig: är det här ett problem, ett klagomål eller en fakturafråga? Ofta är det alla tre.
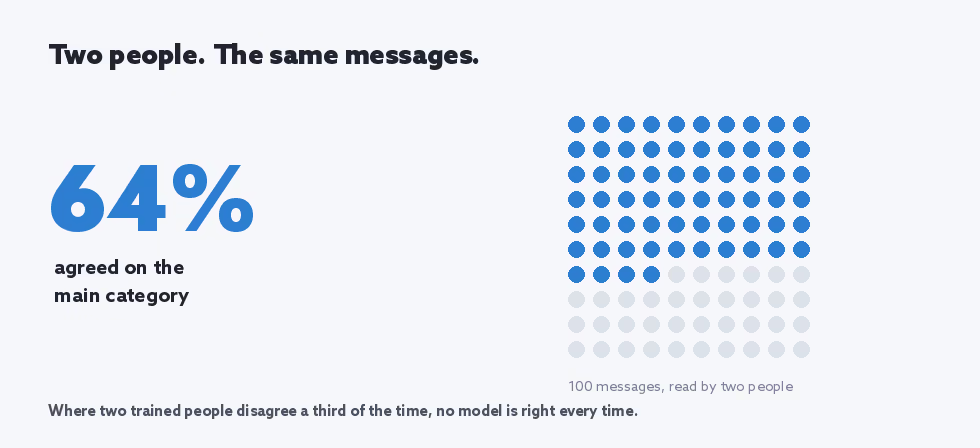
Den siffran publiceras sällan, eftersom den får träffsäkerheten att se mindre imponerande ut. Vi vill hellre att ni har den, eftersom den säger något som inget mått på träffsäkerhet kan säga.
Svaret är att låta modellen säga hur säker den är.
Varför en sannolikhet slår en etikett
De flesta verktyg av det här slaget ger er en etikett. Det här meddelandet är ett klagomål. Ni vet inte om verktyget var säkert eller gissade, så ni kontrollerar allt, och automatiseringen sparar ingen tid åt någon.
Vår modell Nordic Customer Impact anger med varje svar hur säker den är, och de siffrorna är ärliga: när den säger 80 % har den rätt i ungefär 80 % av fallen. Av det blir en regel som vem som helst kan följa:
- Säkert svar → skicka det vidare automatiskt.
- Osäkert svar → skicka det till en människa.
- Allvarligt eller känsligt — en säkerhetsrisk, eller någon i en svår situation — → en människa, omedelbart, oavsett hur säker modellen är.
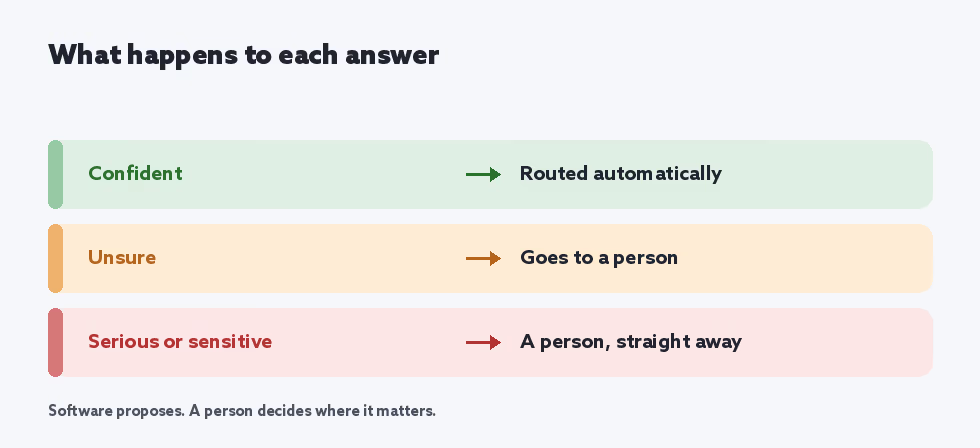
Den sista regeln är inbyggd i referenskoden vi har publicerat, i stället för att någon ska behöva komma ihåg den. Samma tanke går igenom hela plattformen: programvaran föreslår, och en människa bestämmer där det spelar roll.
Där modellerna är som svagast
Fyra begränsningar, alla publicerade på modellkorten.
De har lärt sig av påhittad text. Verkliga dokument är stökigare — förkortningar, stavfel, halva meningar, lokal jargong. Testa dem på ett urval av er egen text innan ni förlitar er på något av det här, och låt en människa vara med där en miss får följder.
Nynorska är den svagaste varianten. Exakt matchning når 0,96 för bokmål mot 0,88 för nynorska. Mindre material att lära sig av, lägre resultat.
Kategorier i fritext har otydliga gränser. Att upptäcka att en mening nämner sjukdom fungerar pålitligt. Att vara överens om exakt var omnämnandet börjar och slutar är svårare — för en modell, och för två människor.
I riskfrågor väljer de försiktighet framför täckning. Signaler som kundbortfall och säkerhetsrisker hittas i 77 till 84 % av de meddelanden som innehåller dem. Där en miss kostar mer än ett falsklarm bör tröskeln sänkas — och det är ett beslut för er verksamhet, inte för oss.
Varför ge bort dem?
En rimlig fråga till ett företag med tre personer och en stram budget.
Delvis för att det kostar oss lite att publicera modellerna, och det ger nordiska organisationer något som för det mesta inte finns: öppna modeller som hanterar norska och svenska personuppgifter ordentligt, körs på er egen hårdvara och kan kontrolleras av vem som helst. Träningsmaterialet behåller vi.
Delvis för att det är det enda ärliga sättet att påstå det. En leverantör som säger vår privata AI skyddar era data ber er att ta dem på orden. Här är modellerna, siffrorna, kategorierna och begränsningarna. Ladda ner dem och testa dem själva.
Vad ni ska fråga varje leverantör vars AI läser era uppgifter
- Vart tar texten vägen? Om svaret innefattar en extern AI-tjänst lämnar uppgifterna i ert personalregister er miljö. Fråga vilken tjänst, och vad den sparar.
- Vad har modellen tränats på? Verkliga kunddokument, eller påhittad text? Om det är verkliga dokument: vems, och med vilket tillstånd?
- Fungerar den på vårt språk? Norskan har två skriftspråk. Svenska, danska och finska är i sin tur andra problem. En modell som får bra resultat på engelska säger er väldigt lite.
- Hur ofta har den fel, och åt vilket håll? Att missa något och att flagga något ofarligt är olika fel med olika kostnader.
- Säger den till när den är osäker? En etikett utan uppgift om hur säker modellen är går inte att automatisera på ett tryggt sätt.
- Kan vi testa den på vår egen text? Om svaret innebär att ni ska ladda upp era verkliga dokument till en demomiljö är den första frågan redan besvarad.
Våra svar står ovan, och modellerna är offentliga, så ni kan kontrollera dem i stället för att ta oss på orden.
Bjørn Nese — Grundare & chefsingenjör
Har byggt driftsprogramvara för branscher med höga compliance-krav sedan 2011. Designar plattformens arkitektur och den privata, interna AI som driver den.
Fler artiklar av Bjørn Nese